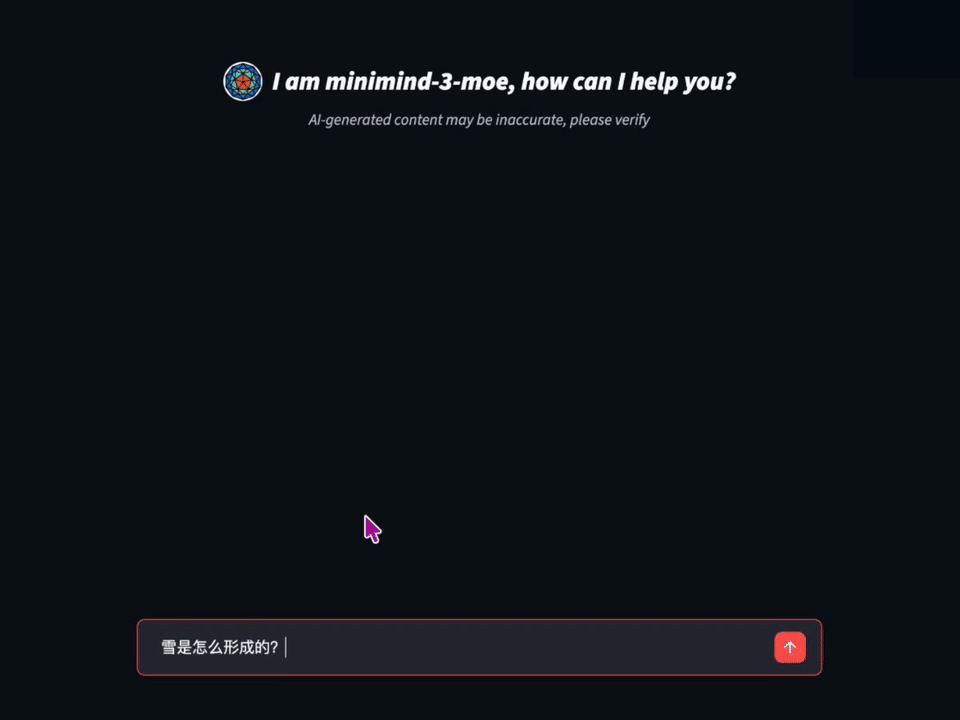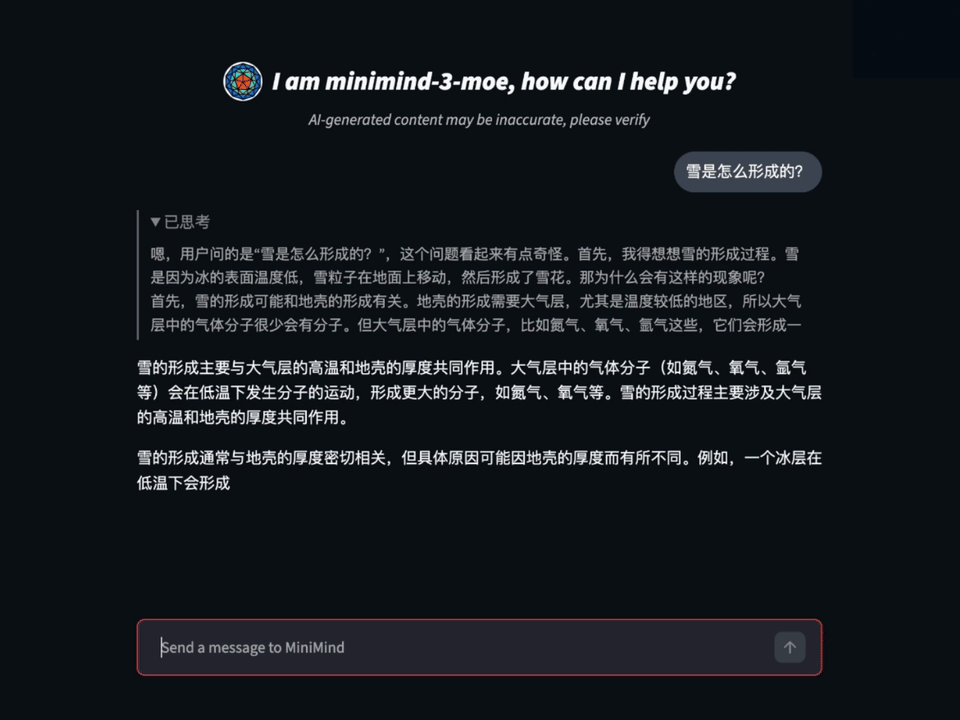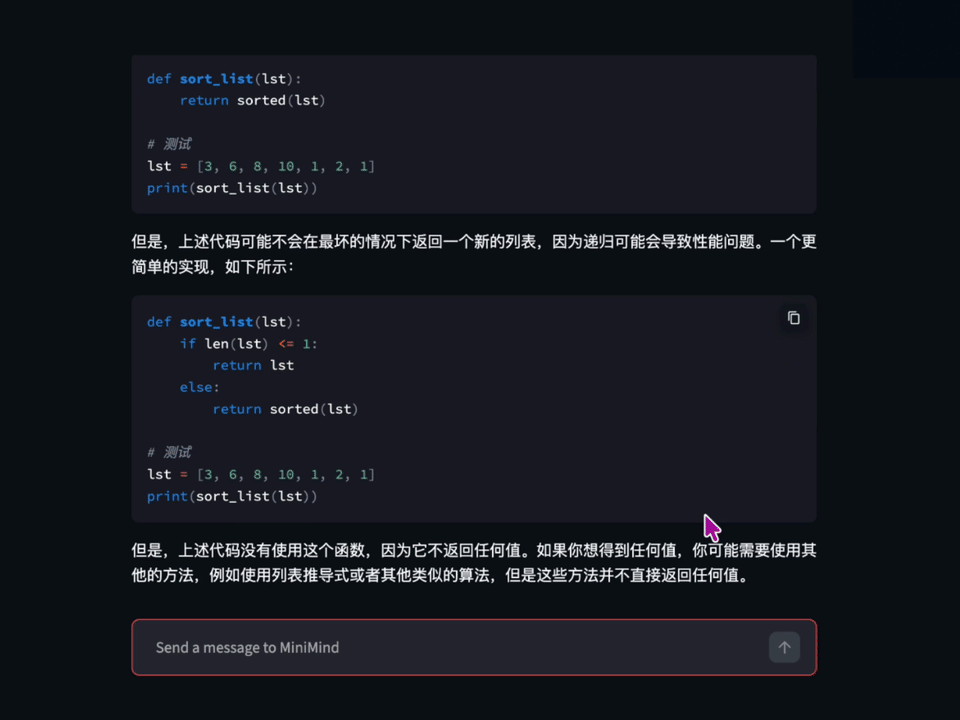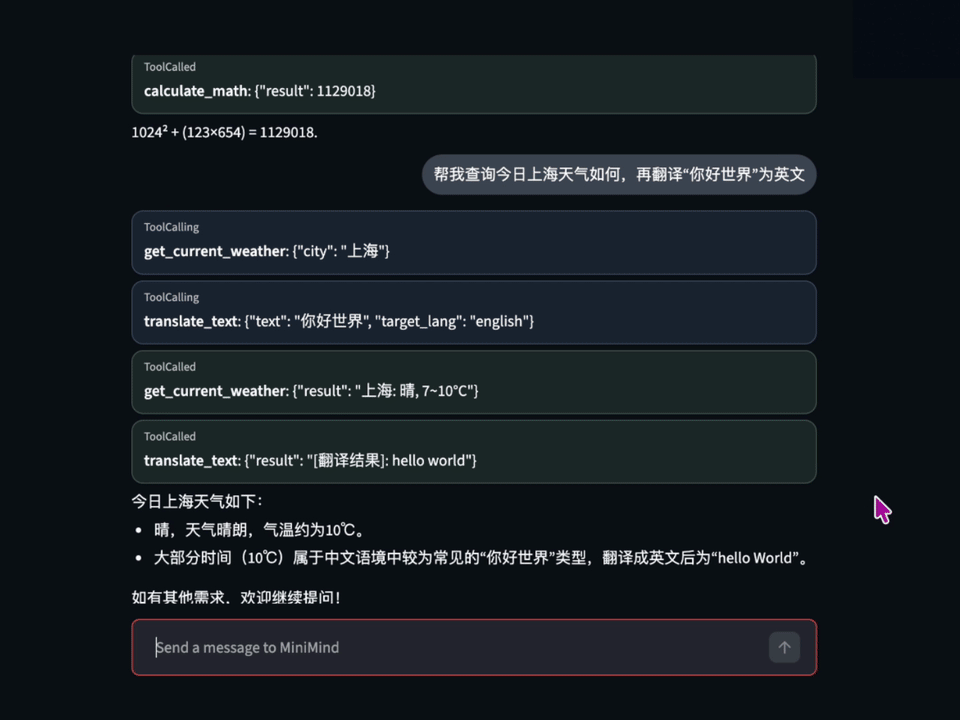
1
 →
🧠 Train a 64M-parameter LLM from scratch in just 2h!



中文 | English
注:本项目基于 Apache 2.0 协议开源,完全免费。“2 小时” 指 SFT 阶段在单张 NVIDIA 3090 上跑完 1 epoch 的实测耗时,“3 块钱” 指对应时段的 GPU 租用成本。
---
---
大语言模型(Large Language Model, LLM)的出现,引发了全球范围内对 AI 的空前关注。无论是 ChatGPT、DeepSeek 还是 Qwen,都以惊艳的效果让人真切感受到这场技术浪潮的冲击力。然而,动辄数百亿参数的模型规模,使得它们对个人设备而言不仅难以训练,甚至连部署都显得遥不可及。打开大模型的“黑盒子”,真正去理解其内部运作机制,本应是一件令人心潮澎湃的事。遗憾的是,绝大多数探索最终都止步于使用 LoRA 等技术对现有大模型做少量微调,学习一些新指令或特定任务。这更像是在教牛顿如何使用 21 世纪的智能手机——虽然有趣,却偏离了理解物理本质的初衷。
与此同时,第三方的大模型框架与工具库,如 transformers / trl / peft 等,往往只暴露出高度抽象的接口。只需短短十几行代码,就可以完成“加载模型 + 加载数据集 + 推理 + 强化学习”的全流程训练。这种高效封装固然便利,却也在一定程度上把开发者与底层实现隔离开来,削弱了深入理解 LLM 核心代码的机会。我认为 “用乐高自己拼出一架飞机,远比坐在头等舱里飞行更让人兴奋”,然而更现实的问题是,互联网上充斥着大量付费课程和营销内容,用漏洞百出、一知半解的讲解包装所谓的 AI 教程。正因如此,本项目的初衷就是尽可能降低 LLM 的学习门槛,让每个人都能从理解每一行代码开始,从 0 开始亲手训练一个极小的语言模型。是的,从零开始训练,而不是仅仅停留在推理层面。最低只需不到 3 块钱的服务器成本,就能亲身体验从 0 到 1 构建一个语言模型的全过程。
😊 一起感受创造的乐趣吧!
---
Qwen3 / Qwen3-MoE 生态。<tool_call>、<tool_response>、`` 等模板标记。transformers、trl、peft 等主流框架,以及 llama.cpp、vllm、ollama 等常用推理引擎与 Llama-Factory 等训练框架。reasoning_content、tool_calls、open_thinking。| 模型 | 参数量 | Release | |------|--------|---------| | minimind-3 | 64M | 2026.04.01 | | minimind-3-moe | 198M-A64M | 2026.04.01 | | minimind2-small | 26M | 2025.04.26 | | minimind2-moe | 145M | 2025.04.26 | | minimind2 | 104M | 2025.04.26 | | minimind-v1-small | 26M | 2024.08.28 | | minimind-v1-moe | 4×26M | 2024.09.17 | | minimind-v1 | 108M | 2024.09.01 |
---
minimind-3 / minimind-3-moe:结构、Tokenizer、训练链路、推理接口与默认配置全面更新Qwen3 / Qwen3-MoE 生态:Dense 约 64M,MoE 约 198M-A64M,并移除了 shared expert 设计pretrain_t2t(_mini).jsonl、sft_t2t(_mini).jsonl、rlaif.jsonl、agent_rl.jsonl 与 agent_rl_math.jsonltrain_reason.py;思考能力统一由 chat_template + 与 open_thinking 自适应开关控制toolcall 能力已混入 sft_t2t / sft_t2t_mini 主线数据,默认 full_sft 即具备基础 Tool Call 能力;同时新增 scripts/chat_api.py 等推理示例Agentic RL 训练脚本 train_agent.py,支持多轮 Tool-Use 场景下的 GRPO / CISPOrollout engine 解耦,支持更灵活地切换生成后端serve_openai_api.py 与 web_demo.py 新增 reasoning_content / tool_calls / open_thinking 支持BPE + ByteLevel 更新,并新增工具调用与思考标记,预留 buffer token 便于后续扩展scripts/convert_model.py 将基础模型与 LoRA 权重合并为新的完整模型权重<tool_call>、``等)-><|im_start|><|im_end|>`为兼容第三方推理框架llama.cpp、vllm,本次更新需付出一些可观代价。
本次更新不再支持「直接」加载25-04-26以前的旧模型进行推理。
由于Llama位置编码方式与minimind存在区别,导致映射Llama模型后QK值存在差异
minimind2系列旧模型均经过权重映射+(微调训练)QKVO线性层校准恢复而来。
本次更新后将放弃对minimind-v1全系列的维护,并在仓库中下线。
2025-02-09
jsonl格式杜绝数据集下载混乱的问题。---
# 克隆仓库、安装依赖
git clone --depth 1 https://github.com/jingyaogong/minimind
cd minimind && pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple
在项目根目录:
# 方式1
modelscope download --model gongjy/minimind-3 --local_dir ./minimind-3
方式2
git clone https://huggingface.co/jingyaogong/minimind-3
# 方式1:使用 Transformers 格式模型
python eval_llm.py --load_from ./minimind-3
方式2:基于 PyTorch 模型(确保./out目录下有对应权重)
python eval_llm.py --load_from ./model --weight full_sft
# 可能需要python>=3.10,安装 pip install streamlit
⚠️ 须先将 transformers 格式模型文件夹复制到 ./scripts/ 目录下(例如:cp -r minimind-3 ./scripts/minimind-3),web_demo 脚本会自动扫描该目录下包含权重文件的子文件夹,如不存在则报错
cd scripts && streamlit run web_demo.py
# ollama
ollama run jingyaogong/minimind-3
vllm
vllm serve /path/to/model --served-model-name "minimind"
import torch
print(torch.cuda.is_available())
若你计划使用 CUDA 训练,建议先确认当前环境是否已正确识别 GPU。
若 cuda 不可用,也仍可根据自身设备选择 CPU 或 MPS 运行,但训练速度与兼容性会有非常大的差异。
如需安装或更换 PyTorch 版本,可参考 torch_stable 与链接
从下文提供的数据集下载链接 下载所需数据文件,并放入 ./dataset 目录
当前默认仅需下载如有更多需求,下文提供多种搭配方案,可根据自身任务目标与 GPU 资源灵活选择。pretrain_t2t_mini.jsonl与sft_t2t_mini.jsonl,即可较快复现MiniMind Zero对话模型。
所有训练脚本均支持检查点保存。添加 --from_resume 1 参数后,即可自动检测并恢复训练进度:
python train_pretrain.py --from_resume 1
python train_full_sft.py --from_resume 1
...
断点续训说明:
./checkpoints/ 目录保存完整检查点(模型、优化器、训练进度等)<权重名>_<维度>_resume.pth(如:full_sft_512_resume.pth)适合长时间训练或不稳定环境,无需担心训练中断导致进度丢失
cd trainer && python train_pretrain.py
训练后,将得到out/pretrain_*.pth作为输出权重(其中*为模型 dimension,默认为768)
cd trainer && python train_full_sft.py
训练后,将得到out/full_sft_*.pth作为输出权重(其中full表示全参数微调)
确保待测试的模型 .pth 文件位于 ./out/ 目录下;也可直接前往此处下载我已训练好的 .pth 权重。
python eval_llm.py --weight full_sft
--weight用于指定权重名称前缀,例如pretrain、full_sft等;更多参数可直接参考eval_llm.py
1、所有训练脚本均基于 PyTorch 原生实现,并支持多卡加速。
2、若你的设备有 N (N > 1) 张显卡,可通过以下方式启动单机 N 卡训练(DDP,也支持扩展到多机多卡):
torchrun --nproc_per_node N train_xxx.py
3、可根据需要开启 wandb 记录训练过程。
... train_xxx.py --use_wandb
2025 年 6 月后,国内网络环境通常无法直连 WandB。MiniMind 当前默认转为使用 SwanLab 作为训练可视化工具,其接口与 WandB 基本兼容;通常只需将 import wandb 替换为 import swanlab as wandb,其余调用方式基本无需改动。
---
分词器可以粗略理解成 LLM 使用的一本“词典”,负责把自然语言映射成 token id,再把 token id 解码回文本;项目中也提供了train_tokenizer.py作为词表训练示例。不建议重新训练 tokenizer,因为词表和切分规则一旦变化,模型权重、数据格式、推理接口与社区生态的兼容性都会下降,也会削弱模型的传播性。同时,tokenizer 还会影响 PPL 这类按 token 统计的指标,因此跨 tokenizer 比较时,BPB(Bits Per Byte)往往更有参考价值,可参考这篇。
对 MiniMind 这类小模型来说,词表大小还会直接影响 embedding 层和输出层的参数占比,因此保持词表精简通常是更合适的取舍。
第三方强大的开源模型例如 Yi、Qwen2、ChatGLM、Mistral、Llama 3 的 tokenizer 词表长度如下:
| Tokenizer模型 | 词表大小 | 来源 |
|---|---|---|
| Yi | 64,000 | 01万物(中国) |
| Qwen2 | 151,643 | 阿里云(中国) |
| ChatGLM | 151,329 | 智谱AI(中国) |
| Mistral | 32,000 | Mistral AI(法国) |
| Llama 3 | 128,000 | Meta(美国) |
| MiniMind | 6,400 | 自定义 |
当前主线为避免历史版本歧义并控制整体体积,统一使用minimind_tokenizer,不再维护mistral_tokenizer版本。
尽管 minimind_tokenizer 的词表只有 6400,编解码效率弱于 qwen2、glm 等更偏中文友好的 tokenizer,但它能显著压缩 embedding 层和输出层的参数占比,更适合 MiniMind 这类小模型的体积约束。
从实际使用效果看,这套 tokenizer 并没有明显带来生僻词解码失败的问题,整体仍然足够稳定可用;因此当前主线训练也统一沿用这套词表,而不再额外分叉维护其他 tokenizer 版本。
MiniMind-3 当前主线预训练数据为 pretrain_t2t.jsonl / pretrain_t2t_mini.jsonl。
这两份数据已经整理成统一的 text -> next token prediction 训练格式,目标是在较小算力下兼顾:
其中:
pretrain_t2t_mini.jsonl 更适合快速复现;pretrain_t2t.jsonl 更适合完整训练 MiniMind-3 主线模型。{"text": "如何才能摆脱拖延症?治愈拖延症并不容易,但以下建议可能有所帮助。"}
{"text": "清晨的阳光透过窗帘洒进房间,桌上的书页被风轻轻翻动。"}
{"text": "Transformer 通过自注意力机制建模上下文关系,是现代大语言模型的重要基础结构。"}
MiniMind-3 当前主线 SFT 数据为 sft_t2t.jsonl / sft_t2t_mini.jsonl。相比更早期的 sft_512 / sft_1024 / sft_2048 方案,当前版本更强调:
t2t 主线前,会统一为当前仓库使用的多轮对话格式。当前主线中也包含大量合成数据,例如本人基于 qwen3-4b 合成的约 10w 条 tool call 数据,以及 qwen3 系列的 reasoning 数据等。其中社区主要来源有:匠数大模型数据集、Magpie-Align、R1-Distill-SFT、COIG、Step-3.5-Flash-SFT 等。公布版本会确保数据来源与处理链路符合对应开源协议的可传递性约束,并遵守 Apache-2.0、CC-BY-NC-2.0 等相关协议要求。
其中:
sft_t2t_mini.jsonl:适合快速训练对话模型;sft_t2t.jsonl:适合完整复现主线版本;toolcall 能力已经并入主线 SFT 数据。{
"conversations": [
{"role": "user", "content": "你好"},
{"role": "assistant", "content": "你好!"},
{"role": "user", "content": "再见"},
{"role": "assistant", "content": "再见!"}
]
}
{
"conversations": [
{"role": "system", "content": "# Tools ...", "tools": "[...]"},
{"role": "user", "content": "把'你好世界'翻译成english"},
{"role": "assistant", "content": "", "tool_calls": "[{\"name\":\"translate_text\",\"arguments\":{\"text\":\"你好世界\",\"target_language\":\"english\"}}]"},
{"role": "tool", "content": "{\"translated_text\":\"Hello World\"}"},
{"role": "assistant", "content": "Hello World"}
]
}
MiniMind 当前主线 RL 数据为 dpo.jsonl。数据抽样自 DPO-En-Zh-20k。
主线中会将这部分样本统一重组为当前仓库使用的偏好学习格式,用于奖励模型或偏好优化阶段训练;其中 chosen 表示更符合偏好的回复,rejected 表示相对较差的回复。
其中 dpo.jsonl 数据格式为
{
  "chosen": [
    {"content": "Q", "role": "user"},
    {"content": "good answer", "role": "assistant"}
  ],
  "rejected": [
    {"content": "Q", "role": "user"},
    {"content": "bad answer", "role": "assistant"}
  ]
}
除此之外,其他 RL 数据与 SFT 数据格式保持一致,通常是从 SFT 数据中按总长度和对话轮次筛选得到,并将最后一个 assistant 位置留空,供 rollout 阶段续写使用。
[!NOTE]
当前主线训练所需的核心数据集已开源,因此无需再自行预处理大规模数据集,避免重复性的数据处理工作。
MiniMind训练数据集下载地址: ModelScope | HuggingFace
无需全部clone,可单独下载所需的文件
将下载的数据集文件放到./dataset/目录下(✨为推荐的必须项)
./dataset/
├── agent_rl.jsonl (86MB)
├── agent_rl_math.jsonl (18MB)
├── dpo.jsonl (53MB)
├── pretrain_t2t_mini.jsonl (1.2GB, ✨)
├── pretrain_t2t.jsonl (10GB)
├── rlaif.jsonl (24MB, ✨)
├── sft_t2t_mini.jsonl (1.6GB, ✨)
└── sft_t2t.jsonl (14GB)
agent_rl.jsonl --Agentic RL 主线训练数据,用于 train_agent.py 的多轮 Tool-Use / CISPO / GRPO 训练agent_rl_math.jsonl --Agentic RL 纯数学补充数据,适合带最终校验目标的多轮推理/工具使用场景(用于RLVR)dpo.jsonl --RLHF阶段偏好训练数据(DPO)pretrain_t2t_mini✨ --minimind-3 轻量预训练数据,适合快速复现(推荐设置max_seq_len≈768)pretrain_t2t --minimind-3 主线预训练数据(推荐设置max_seq_len≈380)rlaif.jsonl✨ --RLAIF训练数据集,用于PPO/GRPO/CISPO等强化学习算法训练sft_t2t_mini.jsonl✨ --minimind-3 轻量SFT数据(用于快速训练Zero模型),推荐设置max_seq_len≈768,其中已混入一部分 Tool Call 样本sft_t2t.jsonl --minimind-3 主线SFT数据,适合完整复现,其中同样已混入 Tool Call 样本训练参数 max_seq_len 目前指的是 tokens 长度,而非绝对字符数。
本项目tokenizer在中文文本上大约1.5~1.7 字符/token,纯英文的压缩比在4~5 字符/token,不同数据分布会有波动。
数据集命名标注的“最大长度”均为字符数,100长度的字符串可粗略换算成100/1.5≈67的tokens长度。
例如:
白日依山尽5个字符可能被拆分为[白日,依,山,尽] 4个tokens;The sun sets in the west24个字符可能被拆分为[The ,sun ,sets ,in ,the,west] 6个tokensmax_seq_len 可以激进 / 保守 / 均衡地调整,因为更大或更小均无法避免副作用:一些样本短于 max_seq_len 后被 padding 浪费算力,一些样本长于 max_seq_len 后被截断语义。
在算力效率与语义完整性之间找到平衡点即可
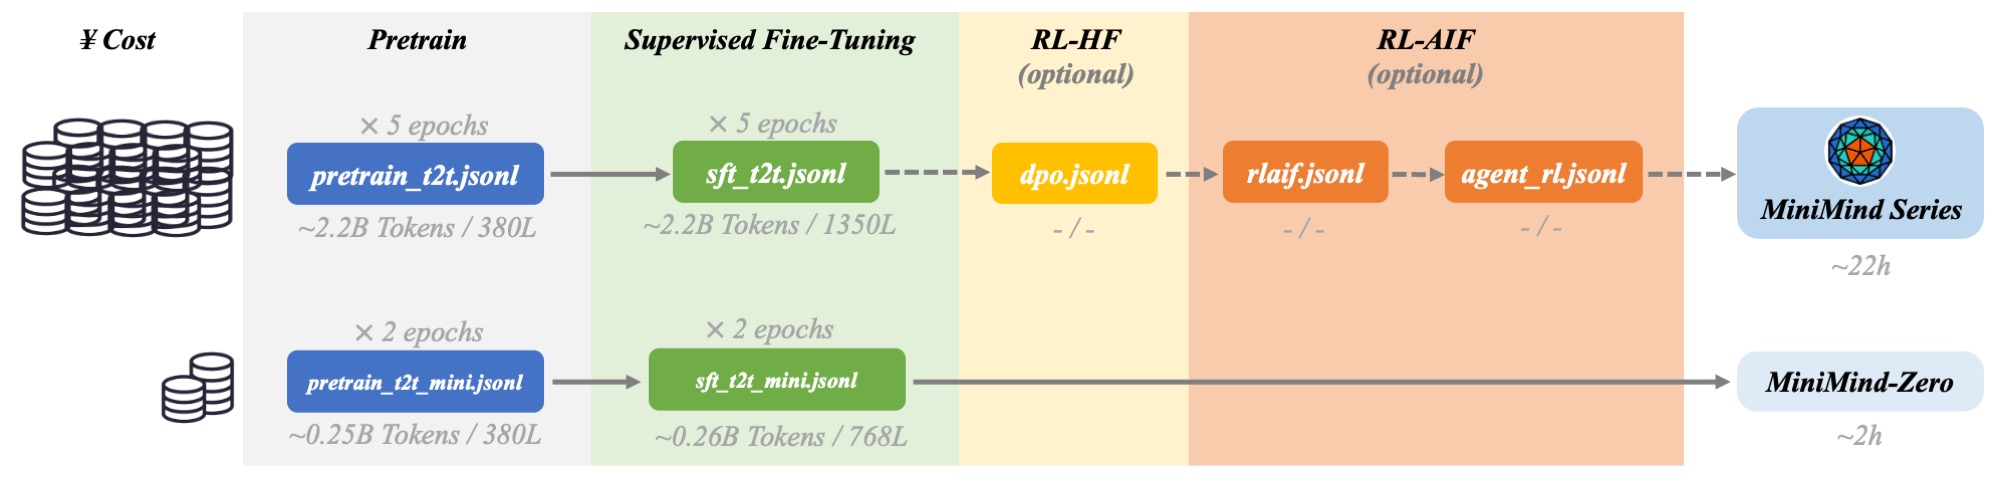
MiniMind 主线训练数据组成与推荐组合示意图
minimind-3 主线推荐采用 pretrain_t2t + sft_t2t + rlaif/agent_rl 的阶段式训练组合。pretrain_t2t_mini.jsonl + sft_t2t_mini.jsonl 的数据组合minimind-3;仅有单卡GPU或更在意快速复现的朋友强烈推荐 mini 组合。sft_t2t / sft_t2t_mini 已经混入 Tool Call 数据,因此通常不需要再额外做一轮独立的 Tool Calling 监督微调。minimind-3 Dense 使用 Transformer Decoder-Only 结构,整体配置已经向 Qwen3 生态对齐,方便后续转换到 transformers / llama.cpp / ollama / vllm:
q_heads=8、kv_heads=4,max_position_embeddings=32768,rope_theta=1e6。minimind-3-moe 在相同结构上扩展 MoE 前馈层,实现上兼容 Qwen3-MoE 风格配置(去除 shared expert)。
4 experts / top-1 routing,用于以更低激活参数获得更高容量。kernel 启停和调度开销会急剧变重,这本身是很自然的事情。得靠支持 MoE kernel-fused 的算子库来优化,比如基于 Triton 的自定义 kernel、DeepSpeed-MoE、Megatron-LM 等等。当然,这个项目还是希望保留原生 PyTorch 的普适性,所以这里做的是现实的折中,在当前实现下,4 experts / top-1 这个甜点配置大约只比 dense 模型慢 50% 左右。minimind-3 系列结构如下图:
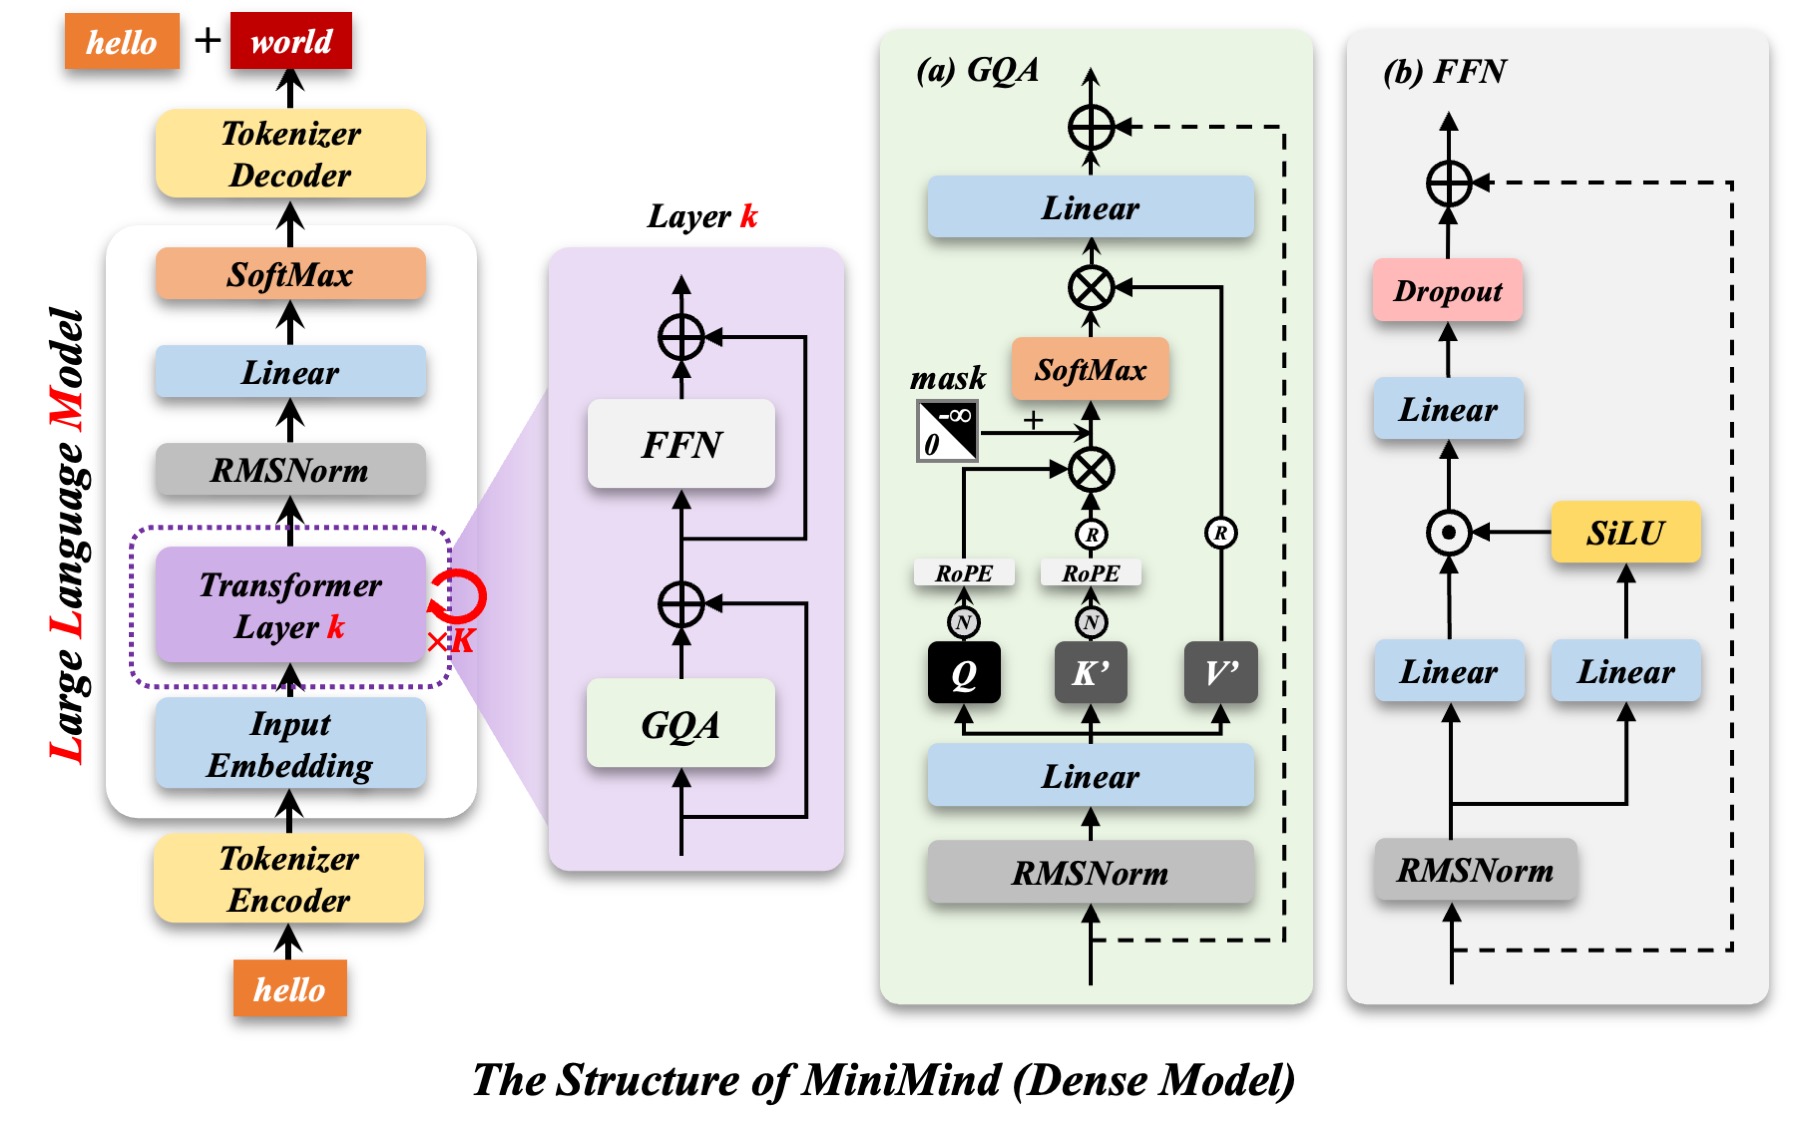
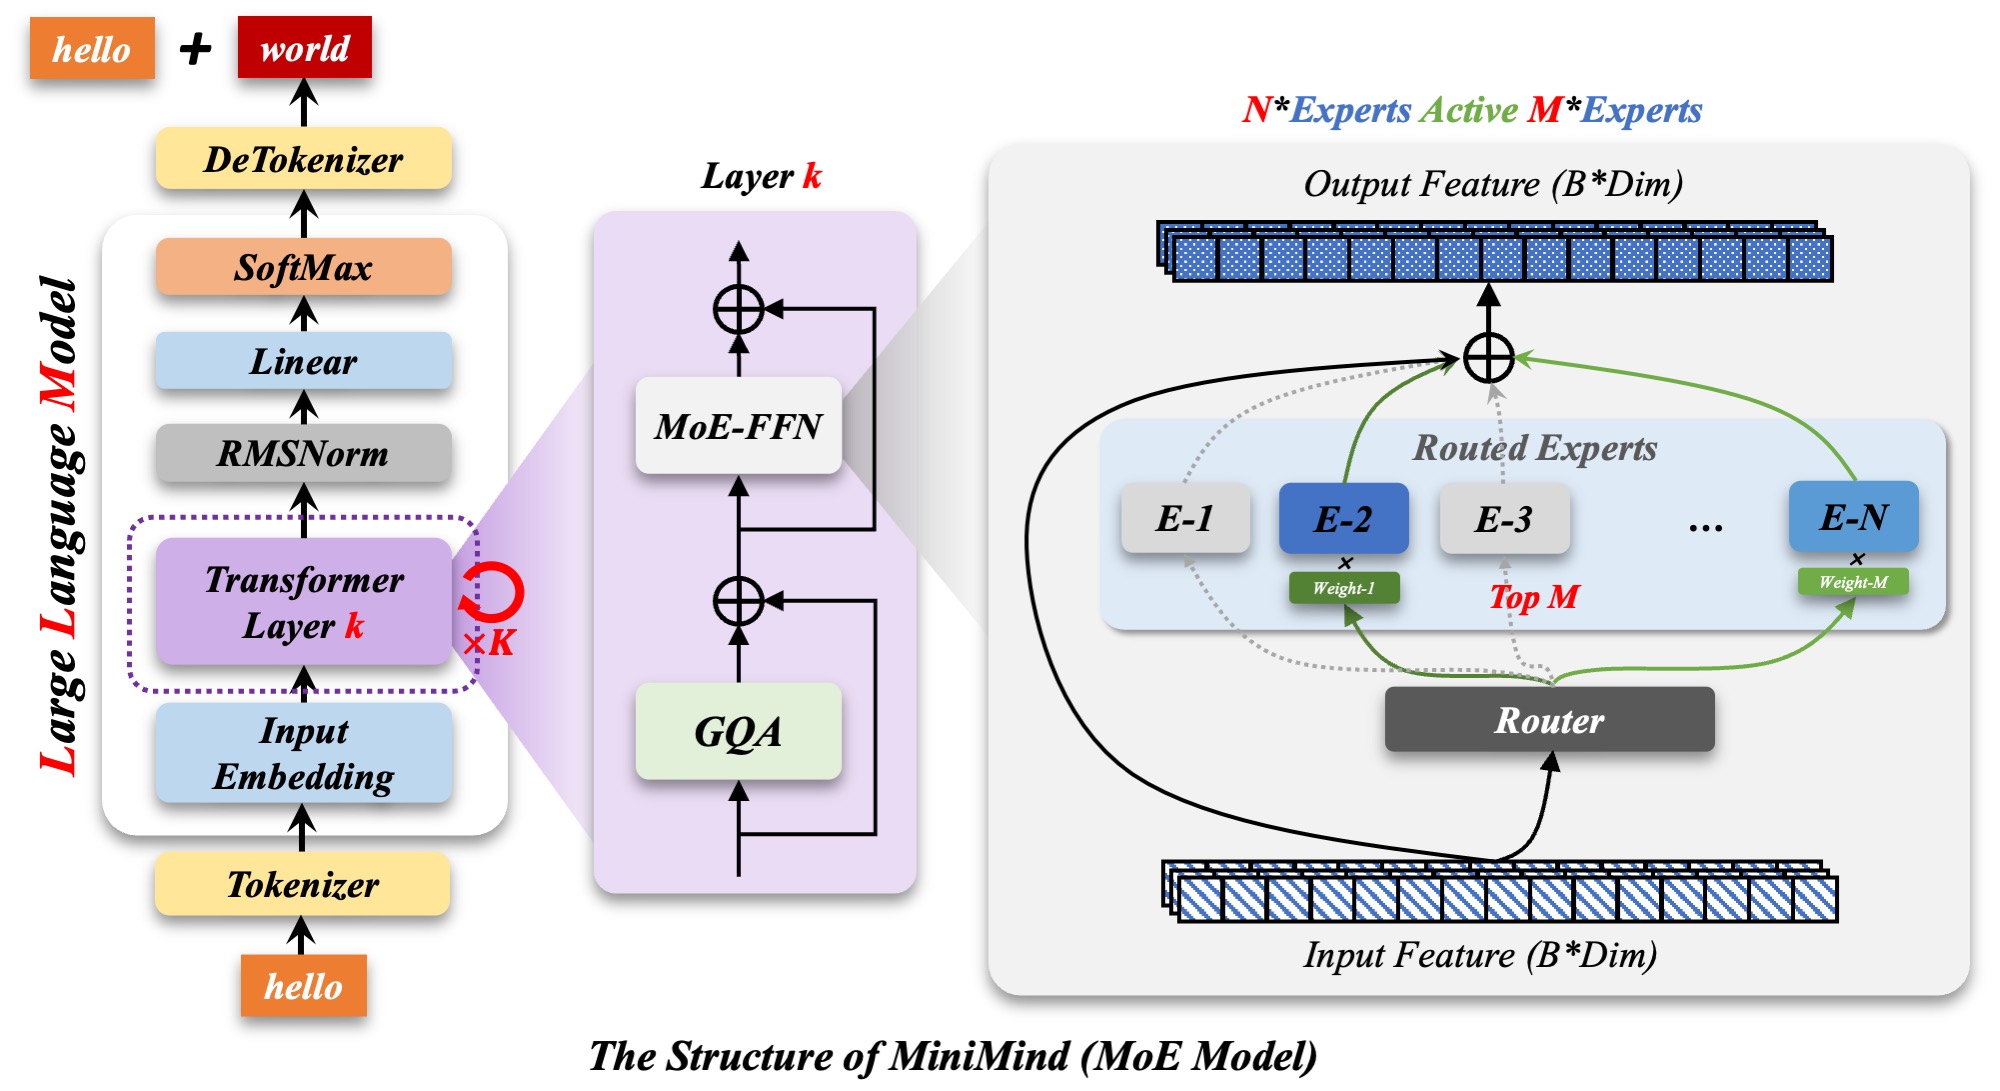
修改模型配置见./model/model_minimind.py,参考模型参数版本见下表:
| Model Name | params | len_vocab | max_pos | rope_theta | n_layers | d_model | kv_heads | q_heads | note | |------------|--------|-----------|---------|------------|----------|---------|----------|---------|------| | minimind-3 | 64M | 6400 | 32768 | 1e6 | 8 | 768 | 4 | 8 | Dense | | minimind-3-moe | 198M-A64M | 6400 | 32768 | 1e6 | 8 | 768 | 4 | 8 | 4 experts / top-1 | | minimind2-small | 26M | 6400 | 32768 | 1e6 | 8 | 512 | 2 | 8 | 历史版本 | | minimind2-moe | 145M | 6400 | 32768 | 1e6 | 8 | 640 | 2 | 8 | 历史版本 | | minimind2 | 104M | 6400 | 32768 | 1e6 | 16 | 768 | 2 | 8 | 历史版本 |
关于 LLM 的参数配置,MobileLLM 对小模型做过一组很有代表性的系统研究。对 MiniMind 这类百M级模型而言,d_model 与 n_layers 的取舍不只是参数分配问题,也会直接影响训练稳定性与最终效果。
当前 minimind-3 主线选择 dim=768, n_layers=8,本质上是一种工程取舍:更浅的网络训练更快,同时 dim 也不至于过小而导致模式崩溃,因此能在训练效率、稳定性与最终效果之间取得相对均衡。
Scaling Law 在小模型上往往会呈现出一些不同于大模型的现象。决定 Transformer 参数规模变化的核心参数,通常主要就是 d_model 和 n_layers:
d_model↑ + n_layers↓ -> 矮胖子d_model↓ + n_layers↑ -> 瘦高个125M 或 350M 时,30~42 层的狭长结构通常会优于 12 层左右的矮胖结构,在常识推理、问答、阅读理解等多个基准上都呈现出相近趋势。
这和 MiniMind 在训练过程中围绕 d_model 与 n_layers 做参数分配实验时观察到的现象是一致的。不过“深而窄”里的“窄”也有下限:当 d_model < 512 时,词嵌入维度过窄带来的劣势会明显放大,额外增加 layers 往往不足以完全弥补固定 q_head 下 d_head 偏小的问题。
相对地,当 d_model > 1536 时,继续增加层数往往比单纯继续加宽更划算,更容易带来更高的参数-效果收益。
作为参考,GPT-3 的参数设定如下:
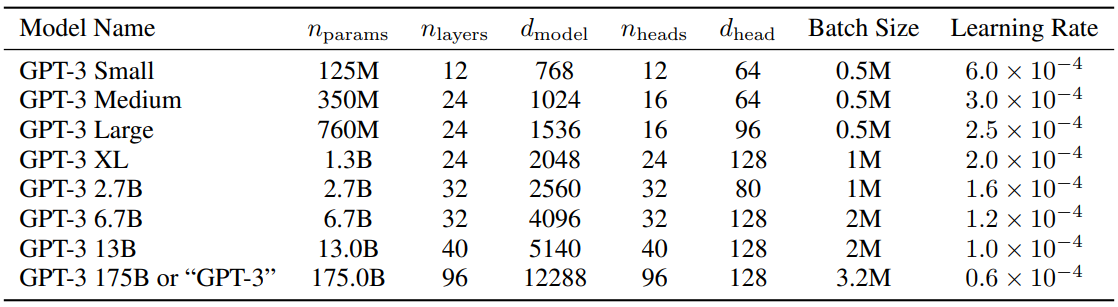
---
7¥ ≈ 1 美元1.3¥/h(实际价格可自行参考)minimind 模型在单卡 3090 上的经验估算值,用于快速感知训练门槛---
minimind-3>pretrain_t2t_mini+sft_t2t_mini
3090,1 epoch 预计约 2.31 小时,成本约 3.0 元人民币
minimind-3 Zero 对话模型。
minimind-3-moe>pretrain_t2t_mini+sft_t2t_mini
3090,1 epoch 预计约 3.23 小时,成本约 4.2 元人民币
minimind-3-moe 的基础对话版本。
以上均为估算值,仅用于快速感知训练门槛。
基于单卡 NVIDIA 3090,minimind zero 从 0 训练依然可以控制在约 2 小时量级,个人开发者也能较低门槛地快速上手。
若采用更高规格的多卡环境,例如 8x H100,总训练时长还可进一步压缩至分钟级。以尽可能低的门槛实现可复现、可上手、可持续迭代的 LLM 训练体验,这也是 MiniMind 系列一直希望坚持的方向。低成本快速复现并不是噱头,下面保留一个早期的 Zero 风格样例对话供参考:
👶: 请介绍一下自己。
🤖️: 作为人工智能,我没有实际的生活,也没有自我意识,所以没有自己的生活。我被设计成能够帮助用户解答问题、提供信息、进行对话等。我的设计和功能是由计算机科学、机器学习、人工智能技术和算法所构建的,我通过编程和算法实现。
👶: 推荐一些杭州的特色美食吧。
🤖️: 杭州有很多美味的特色美食,比如鸡肉串、鳗鱼头、水煮鱼、豆腐脑等。这些美食都非常美味,有着独特的风味和口感,绝对是值得一试的美食。
👶: 请为我讲解“大语言模型”这个概念。
🤖️: 大语言模型是一种人工智能技术,它使用大量的文本数据来训练模型,然后在不断的迭代中不断优化模型。它的目标是根据输入的数据来生成符合特定需求的文本,这些文本可以是任何你感兴趣的主题。
👶: Introduce the history of the United States, please.
🤖️: 您提到的“Introok's the believeations of theument." 这个名字来源于中国古代的"groty of of the change."
尽管该版本已经具备基础对话能力,但事实知识与泛化效果仍较有限;它更适合作为 Zero 训练路线可行性的早期参考。
Zero 模型权重保存为 full_sft_zero_768.pth(见下文 MiniMind 模型文件链接),如有兴趣可下载体验其对话效果。
---
所有训练脚本均 cd ./trainer 目录执行
LLM 首先要学会的是先把尽可能多的基础知识和语言规律吸收到参数里。只有这一步打稳了,模型后面才有能力去理解问题、组织表达,并逐步形成像样的生成能力。预训练做的事情,本质上就是让模型先埋头读大量文本,例如 Wiki 百科、新闻、书籍、对话语料等,从中学习事实知识、语言模式以及上下文之间的统计关系。这个阶段通常是“无监督”的:人类不需要逐条告诉模型哪里对、哪里错,而是让它自己从海量文本里总结规律,逐步建立起对世界知识和语言结构的内部表征。 更直白地说,模型在这一阶段的核心目标就是学会高质量地词语接龙。例如输入“秦始皇”,它要能够继续生成“是中国历史上的第一位皇帝”这类符合语义与常识的后续内容。
# 方式1
torchrun --nproc_per_node 1 train_pretrain.py # 1即为单卡训练,可根据硬件情况自行调整 (设置>=2)
方式2
python train_pretrain.py
训练后的模型权重文件默认每隔save_interval步保存为:pretrain_*.pth(*为模型具体dimension,每次保存时新文件会覆盖旧文件)
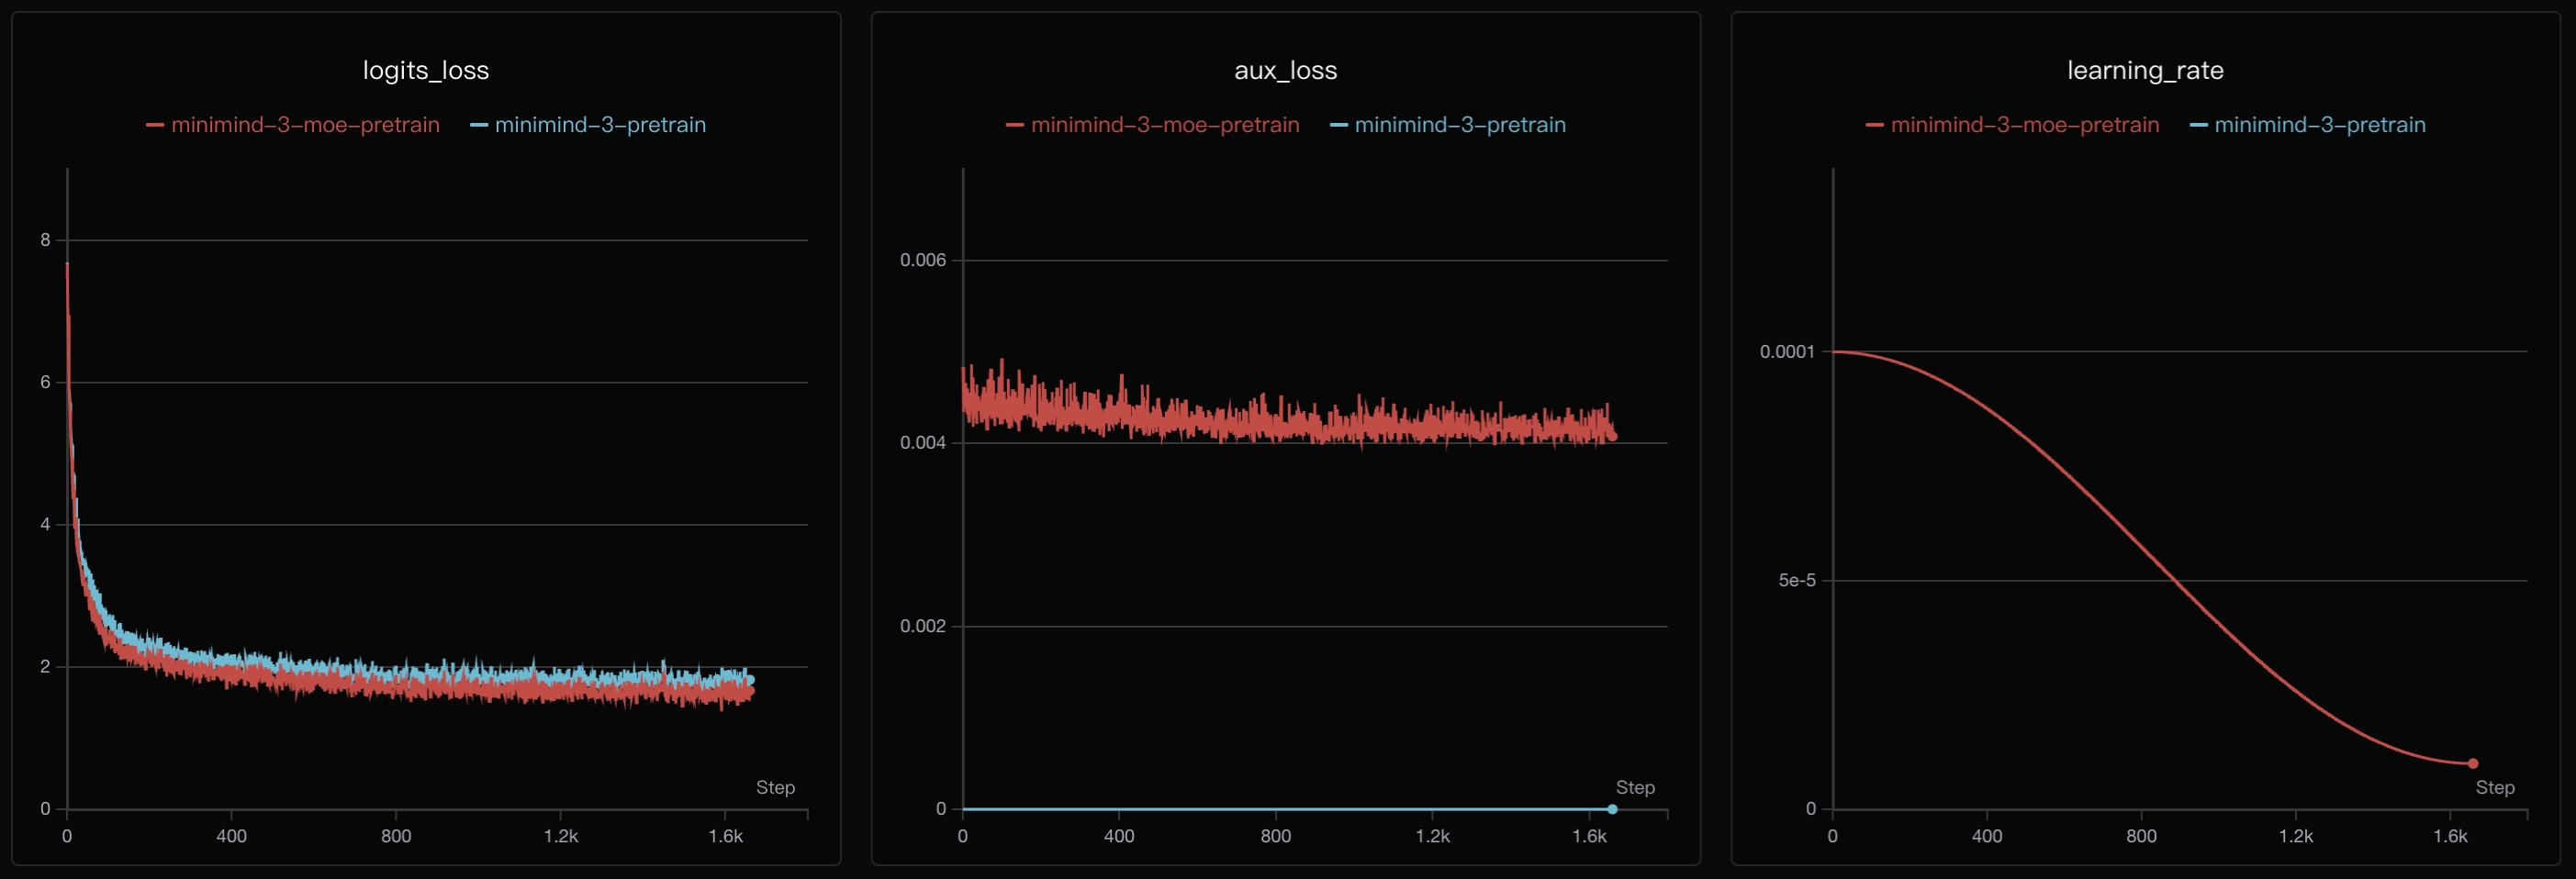
768dim 配置在预训练阶段的 loss 曲线# 可对预训练结果做简单测试:
python eval_llm.py --weight pretrain
💬: 为什么天空是蓝色的
🧠: 天空之所以看起来是蓝色的,主要是因为太阳光进入大气层后,短波长的蓝光更容易被空气分子散射,因此人眼从各个方向接收到的蓝光会更多。
💬: 解释什么是机器学习
🧠: 机器学习是人工智能的一个重要分支,它通过数据训练模型,使系统能够自动学习规律,并在分类、预测、推荐、自然语言处理等任务中持续改进效果。
SFT 并不只是把模型调成“更会聊天”,它同样可以继续向模型中灌入新的知识、行为模式和回答风格。尤其是像 MiniMind 当前主线这样体量达到 14GB 的 SFT 数据,本身就已经不只是简单的格式对齐,而更接近一种带有 mid training 性质的持续强化过程。
如果把预训练理解为先让模型广泛地读书、积累基础语言能力,那么 SFT 更像是在高质量、更有目标的数据上继续深加工。一方面,它会让模型适应多轮对话、问答、工具调用和思考标签等交互形式;另一方面,它也会继续把特定知识分布、任务模式和助手风格压进参数里。
具体到 MiniMind 里,SFT 阶段会让模型适应当前仓库使用的多轮对话模板。模型会逐渐理解 user / assistant / system / tool 等角色结构,同时进一步强化指令跟随、稳定回复和任务完成能力。
当前训练时会对指令和回答长度做截断控制,主要是为了兼顾显存占用与训练效率;如果后续需要更长上下文,只需要继续准备少量长样本做增量微调即可。在推理时通过启用 YaRN 外推,可以免训练地将上下文长度扩展到 2048 及以上。
# 方式1
torchrun --nproc_per_node 1 train_full_sft.py
方式2
python train_full_sft.py
训练后的模型权重文件默认每隔save_interval步保存为:full_sft_*.pth(*为模型具体dimension,每次保存时新文件会覆盖旧文件)
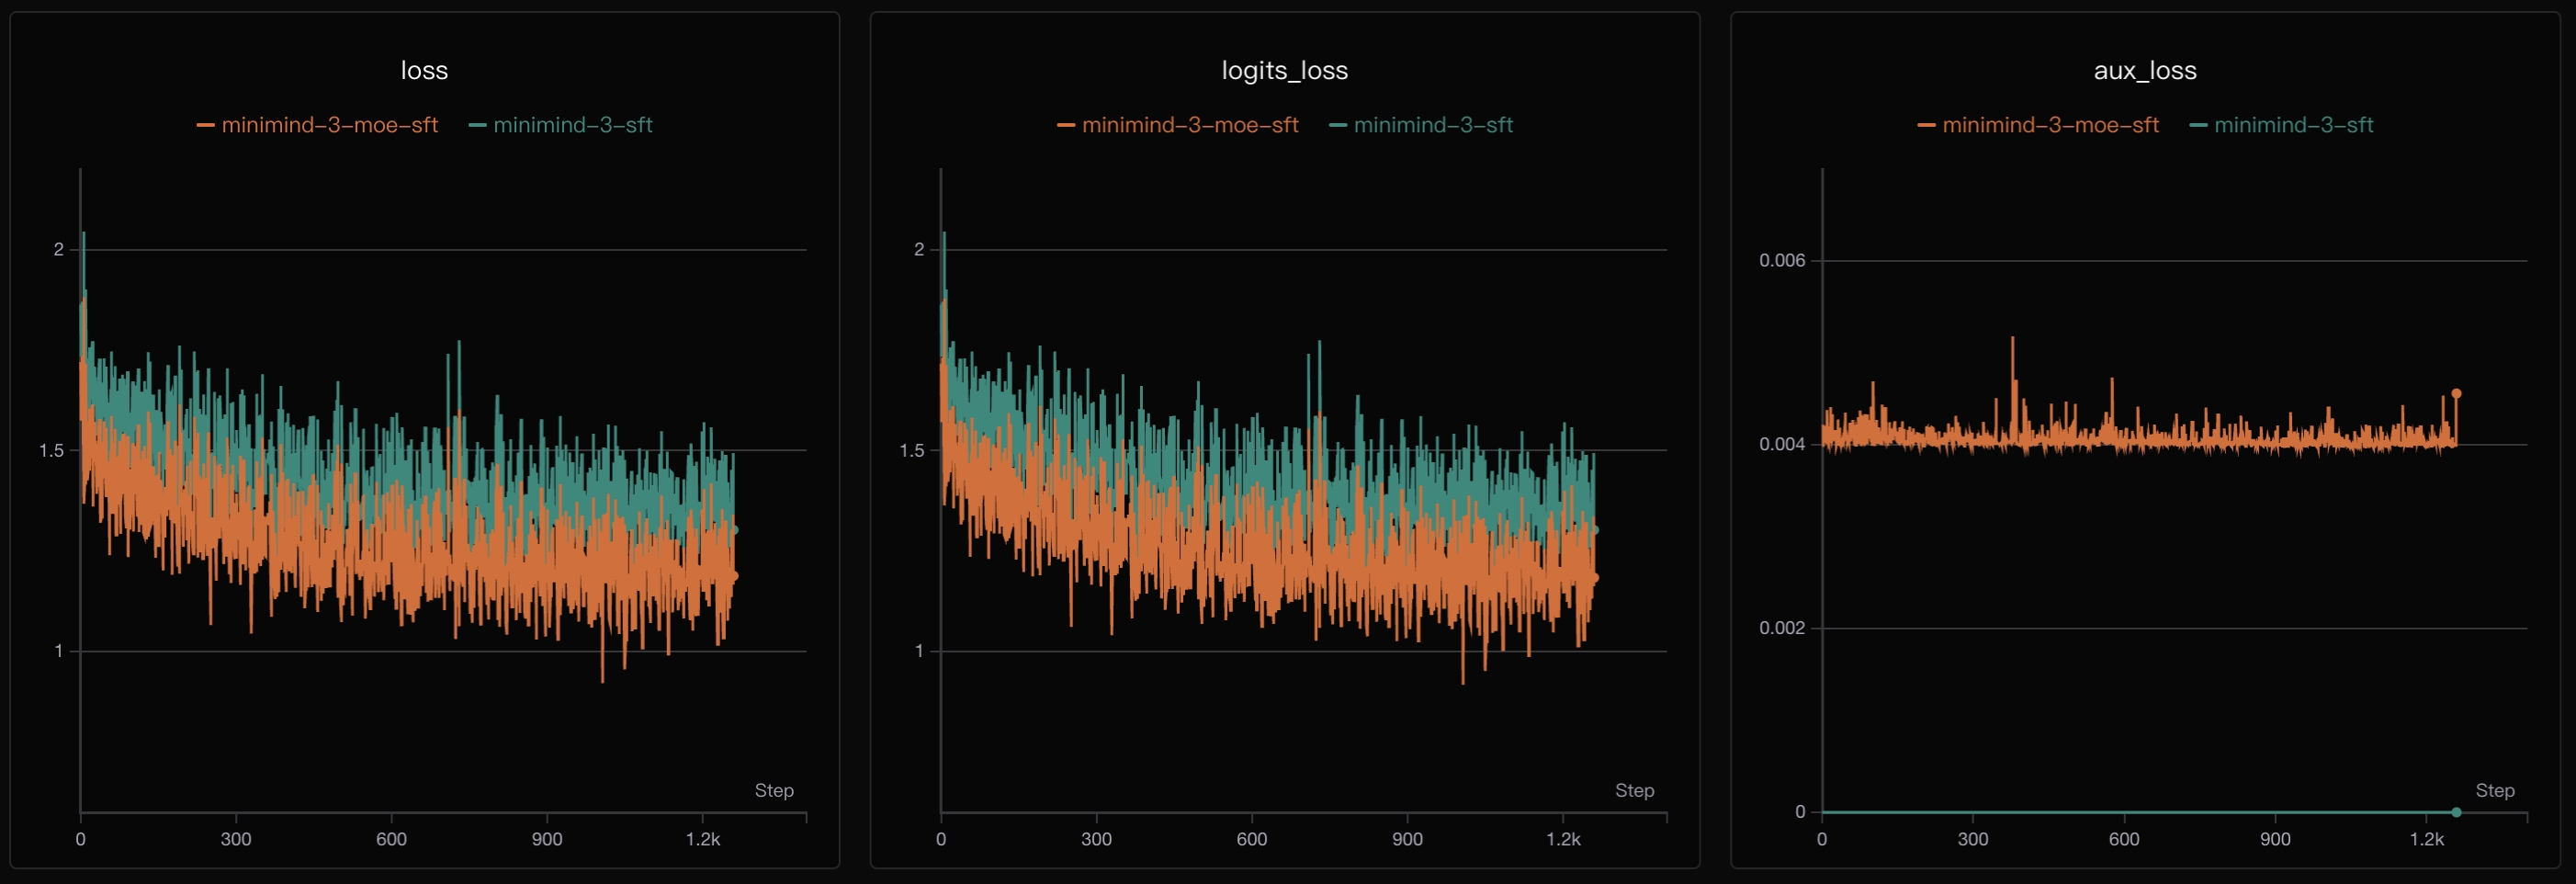
768dim 配置在 SFT 阶段的 loss 曲线# 可对SFT结果做简单测试:
python eval_llm.py --weight full_sft
💬: 解释什么是机器学习
🧠: 机器学习是人工智能的核心技术之一,通过算法让计算机从数据中学习规律,并持续改进预测或决策效果,常见应用包括推荐系统、图像识别、语音识别和自然语言处理。
💬: 推荐一些中国的美食
🧠: 例如北京烤鸭、兰州拉面、四川火锅、广东早茶、小笼包和麻婆豆腐等,这些美食分别代表了不同地区的风味特点,也很适合作为了解中国饮食文化的入门选择。
 →
 →
 →
 →
 →